Karpenter в продакшене: чему учит миграция 1000 кластеров
В Salesforce перевели больше 1000 кластеров EKS с Cluster Autoscaler на Karpenter. Что показывает этот кейс, три ловушки и поэтапный переход.
Виктор Ведмич · 16 мин чтения
В Salesforce больше 1000 кластеров Amazon EKS, и с середины 2025 года их переводят с Cluster Autoscaler на Karpenter. Итоги описаны в кейсе в блоге AWS Architecture, его написали сотрудники Salesforce вместе с AWS. Прежде чем открыть его, угадай, какая цифра там самая большая.
Не экономия. Ручной операционной работы стало на 80% меньше: помогли автоматизация и самообслуживание, когда команды сами описывают нужные им пулы нод. Задержка масштабирования сократилась с минут до секунд. Тысячи групп нод исчезли. А теперь страшная тайна: скромнее всего в кейсе выглядит строчка про деньги. В 2026 финансовом году в Salesforce сэкономили 5% за счёт более плотной упаковки подов и меньшего простоя мощностей. На 2027 финансовый год ждут ещё от 5 до 10%, пока миграция продолжается.
При таком масштабе даже 5% экономии заметны. Но кейс не о том, что «Karpenter вдвое режет счёт». Он о том, что Karpenter снимает с платформенной команды много рутины, а самое трудное в переходе другое: как убирать и менять ноды, не роняя сервисы. Уроки, которые перечисляют в Salesforce, как раз об этом. Слишком строгие PodDisruptionBudget мешали заменять ноды, одновременный cordon (запрет размещать на ноде новые поды) бил по здоровью кластера, а консолидация задевала поды в единственной реплике.
Статья устроена так же: чем Karpenter отличается, три ловушки, где его сильные стороны оборачиваются против команды, поэтапный переход и что мониторить. Конфигурации написаны для API karpenter.sh/v1 и сверены с документацией Karpenter v1.14. Сразу оговорюсь: я работаю в AWS.
Чем Karpenter отличается
Cluster Autoscaler масштабирует группы нод. Karpenter масштабирует ноды.
Звучит как игра слов, пока не посмотришь на механику. Cluster Autoscaler по умолчанию раз в 10 секунд ищет поды, которые планировщик не смог разместить. Затем выбирает группу, новые ноды которой смогут принять эти поды, и увеличивает её размер. В AWS дальше работает группа Auto Scaling: она и запускает инстанс. Cluster Autoscaler рассчитывает, что у нод одной группы одинаковые ресурсы. Смешивать в группе можно только типы инстансов с одинаковым объёмом CPU, памяти и GPU, а для другого набора ресурсов нужна отдельная группа. Так в Salesforce и набрались тысячи групп.
Karpenter обходится без групп. Он следит за подами, которые не удалось разместить, и собирает их в пачку (по умолчанию окно закрывается после секунды без новых подов и длится не больше 10 секунд). Потом плотно раскладывает их по запросам ресурсов и ограничениям размещения и запускает инстансы напрямую через EC2 Fleet, выбирая из типов, которые разрешает NodePool. Посредника в виде группы нод нет, поэтому при нехватке мощностей Karpenter пробует другой вариант за миллисекунды, а не за минуты.
Этот путь Karpenter не сокращает. Каждый под по-прежнему размещает планировщик. Karpenter вступает в дело, когда планировщик сдаётся: запускает ноду для ожидающих подов, и как только она готова, планировщик привязывает их к ней. Экономится время на запуске ноды. Никакой группы Auto Scaling по дороге нет, а именно эту задержку и называют в кейсе Salesforce.
Сколько это «секунд» на практике? Документированной цифры нет. Путь от ожидающего пода до работающего складывается из запуска инстанса, начальной настройки ноды, её перехода в Ready, загрузки образов и старта приложения. Медленный AMI или тяжёлый образ легко съедают большую часть этого времени. Измеряй этапы по отдельности: karpenter_pods_startup_duration_seconds показывает время от создания пода до запуска. Хвост обычно режут так: заранее кладут тяжёлые образы в AMI или облегчают сами образы.
В продакшене вторая половина истории важнее. Karpenter управляет нодами и после запуска. Консолидация убирает или заменяет ноду, если её поды помещаются на других нодах или на более дешёвой. Дрейф (drift) заменяет ноды, которые разошлись со своим NodePool или EC2NodeClass. Истечение срока жизни (expiration) выводит из работы старые ноды. Большинство сюрпризов в продакшене живёт здесь, и две ловушки из трёх как раз про это.
Ловушка 1: скорость без потолка
Часто пишут, что Karpenter укладывается меньше чем в минуту, а Cluster Autoscaler тратит несколько минут. Документация не обещает таких сроков ни тому, ни другому, так что считай подобные сравнения байками. Настоящая ловушка в том, к чему эта скорость прикручена.
В Cluster Autoscaler у каждой группы нод был максимальный размер. Даже в примере старой конфигурации из кейса Salesforce для группы Auto Scaling явно заданы минимальное и максимальное число нод. У NodePool в Karpenter потолка по умолчанию нет: если spec.limits не задан, ограничивает только квота EC2. Деплоймент, который по ошибке растянули до 500 реплик, или автоскейлер, который гонится за сломанной метрикой, получит столько мощностей, сколько просит, и быстро.
Ещё одно популярное утверждение держится на мифе: будто Karpenter хватает любой подходящий инстанс и без ограничений выдаёт 96-ядерного монстра для трёх маленьких подов. Выбор устроен иначе. Karpenter упаковывает пачку подов, находит самый маленький тип инстанса, куда она помещается, и передаёт в EC2 Fleet этот тип и ещё 59 подходящих типов покрупнее. Для On-Demand Fleet берёт самый дешёвый, для Spot взвешивает цену и риск прерывания. Большие ноды всё же появляются, в основном из больших пачек: при резком масштабировании много подов уезжает на меньшее число крупных нод. А большая нода означает большой радиус поражения. Одно прерывание или одна консолидация переносит всё, что на ней работает.
Поэтому исправление опирается на две разные ручки, и их легко перепутать:
spec.limitsограничивает NodePool целиком: суммарные CPU, память или число нод. Размер отдельной ноды он не ограничивает. Данные для проверки лимитов обновляются с задержкой (eventually consistent), поэтому при массовом параллельном запуске нод лимиты можно превысить. Когда лимит превышен, Karpenter больше не запускает ноды для этого NodePool, пока часть нод не уйдёт.requirementsограничивают характеристики каждой ноды.karpenter.k8s.aws/instance-cpuограничивает размер ноды,karpenter.k8s.aws/instance-categoryоставляет вычислительные семейства, семейства общего назначения и с упором на память. Ограничивай размеры, а не разнообразие семейств: в FAQ Karpenter прямо сказано, что чем больше разных типов инстансов, тем дольше удаётся оставаться на Spot.
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: general
spec:
  template:
    spec:
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
      requirements:
        # Сначала Spot, при нехватке On-Demand
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["spot", "on-demand"]
        # Семейства c, m и r: вычислительные, общего назначения, с упором на память
        - key: karpenter.k8s.aws/instance-category
          operator: In
          values: ["c", "m", "r"]
        # Размер каждой ноды: 4, 8, 16 или 32 vCPU
        - key: karpenter.k8s.aws/instance-cpu
          operator: In
          values: ["4", "8", "16", "32"]
  # Потолок для всего NodePool, а не для одной ноды
  limits:
    cpu: "1000"
    memory: 1000Gi
Пара слов о Spot. Если разрешены и spot, и on-demand, Karpenter предпочитает Spot и переходит на On-Demand, когда подходящих спотовых предложений нет, причём, по словам документации, «обычно за миллисекунды». Никакого 60-секундного таймера, который нужно настраивать, нет. Тип инстанса и зону, где только что не хватило мощностей, Karpenter пропускает следующие 3 минуты. Экономия зависит от спотового рынка, а PDB никак не защищает от отзыва спотового инстанса. Отдавай Spot нагрузкам, которые переживут предупреждение за две минуты, а освобождение нод оставь обработке прерываний (о ней ниже).
Ловушка 2: два автоскейлера, один ожидающий под
Во время миграции оба какое-то время работают вместе, и это поддерживаемый сценарий: в FAQ Karpenter сказано, что он умеет работать рядом с Cluster Autoscaler. Проблемы начинаются, когда один и тот же ожидающий под подходит обоим.
Что происходит на деле. Оба контроллера реагируют на поды, которые планировщик пометил как неразмещаемые. Cluster Autoscaler увеличивает группу нод, в шаблон которой под помещается, а Karpenter запускает ноду для того же пода. Одна потребность, две новые ноды. Планировщик привязывает под к той, что первой перешла в Ready, а вторая стоит пустой, пока её не уберёт владелец: Karpenter через консолидацию, Cluster Autoscaler после задержки на уменьшение (по умолчанию 10 минут).
Заметь, чего не происходит: Karpenter не освобождает ноду Cluster Autoscaler. Он трогает только ноды, которые запустил сам, то есть те, за которыми стоит NodeClaim из NodePool. Остальные ноды кандидатами не становятся, так что популярная история о том, что оба автоскейлера консолидируют одни и те же ноды, неверна. На деле они мешают друг другу тише. Когда Karpenter решает, можно ли убрать свою ноду, он учитывает свободное место на всех нодах кластера, включая ноды групп. Cluster Autoscaler задаёт тот же вопрос про свои ноды: можно ли перенести эти поды куда-то ещё? В итоге поды кочуют между двумя пулами, а за лишние запуски приходится платить.
Исправление: решить, какие поды куда могут попасть. Разделить ноды между автоскейлерами недостаточно. Одного тейнта тоже мало: толерация разрешает подам размещаться на нодах с этим тейнтом, но не закрепляет их за этими нодами. Для выделенных нод документация Kubernetes рекомендует сочетать тейнт с меткой и обязательным правилом привязки подов к нодам (nodeAffinity). Для системных нод в EKS принят taint CriticalAddonsOnly=true:NoSchedule: по документации EKS, его допускают многие дополнения, включая CoreDNS, а Helm-чарт Karpenter допускает его по умолчанию.
# Шаблон пода системного деплоймента (например, metrics-server)
spec:
  tolerations:
    - key: CriticalAddonsOnly
      operator: Exists
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              # Метка, которую управляемые группы нод EKS ставят на свои ноды
              - key: eks.amazonaws.com/nodegroup
                operator: In
                values: ["system"]
У подов приложений такого toleration нет, поэтому группа нод с taint им не подходит, и Cluster Autoscaler не увеличивает её ради них. Их обслуживают NodePool в Karpenter. Системные поды требуют группу system по метке. Если под требует метку, которую Karpenter не знает, Karpenter для него ноду не запускает, и такие поды остаются группе нод.
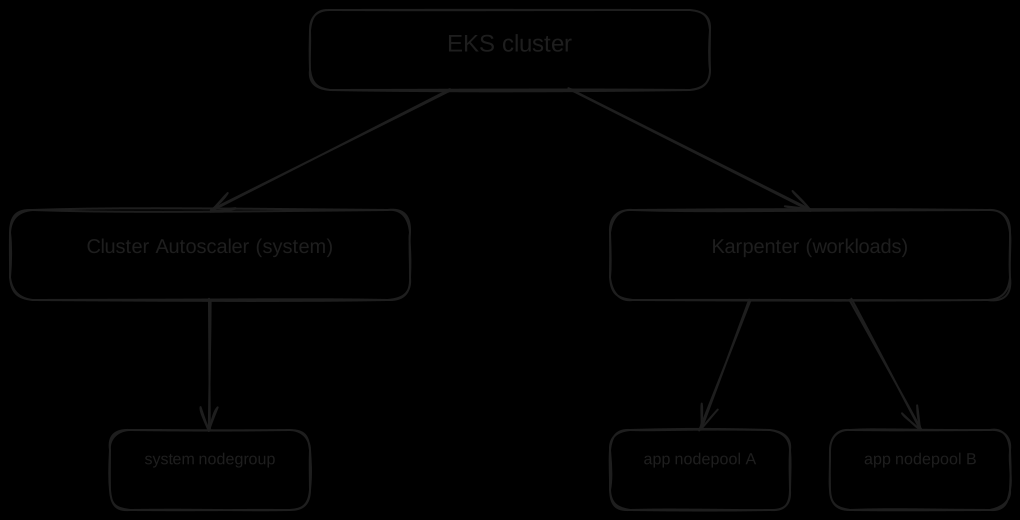
Такое разделение нужно на время миграции, но не обязательно остаётся навсегда. Руководство Karpenter по переходу с Cluster Autoscaler заканчивается тем, что Cluster Autoscaler масштабируют до нуля реплик, а группу нод сжимают до небольшого фиксированного размера для самого Karpenter и критичных дополнений. Для одной группы нод на несколько зон доступности руководство советует минимум два инстанса.
Ловушка 3: консолидация гоняет поды в пик трафика
Консолидация это двигатель экономии в Karpenter, и она срабатывает, как только сходится арифметика, в рабочие часы тоже. Если блок disruption не написать совсем, Karpenter подставит consolidationPolicy: WhenEmptyOrUnderutilized, consolidateAfter: 0s и один бюджет nodes: 10%. В старых примерах встречается WhenUnderutilized: так значение называлось до v1, и karpenter.sh/v1 его не примет.
Типичная сцена в 14:00: по запросам ресурсов поды с двух нод помещаются на одну. Обрати внимание на «по запросам». Консолидация считает по requests и ограничениям размещения, а не по живым графикам CPU. Karpenter ставит taint на одну ноду, при необходимости заранее поднимает замену и вытесняет поды через Eviction API. Если вытеснить единственную реплику, которая обслуживает запросы, сервис перестанет отвечать. А без PDB при освобождении нод можно разом потерять слишком много реплик, даже если их несколько. Это урок Salesforce почти дословно: консолидация неожиданно задевала поды в единственной реплике.
consolidateAfter задаёт, сколько нода должна простоять без изменений, прежде чем станет кандидатом. Таймер сбрасывается каждый раз, когда на ноду приходит под или с неё уходит. При 0s после добавления или удаления подов нет паузы перед проверкой консолидации, а несколько минут дают составу подов устояться. С API v1 это поле обязательно, как только пишешь блок disruption.
spec:
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 5m
    budgets:
      # Постоянный бюджет: 10% нод с округлением вверх
      - nodes: "10%"
      # Пн-Пт 09:00-18:00 UTC: никаких добровольных замен
      - schedule: "0 9 * * 1-5"
        duration: 9h
        nodes: "0"
Бюджета два, и первый важен не меньше второго. Как только задаёшь budgets, дефолтные 10% пропадают. Одинокий бюджет nodes: "0" с расписанием активен только внутри своего окна. Вне окна активных бюджетов нет, и Karpenter может убирать сколько угодно нод одновременно. Постоянный бюджет закрывает эту дыру. Если активны несколько бюджетов, Karpenter берёт самый строгий. Бюджеты ограничивают только добровольные замены: даже в нулевом окне Karpenter запускает ноды для подов, которые не удалось разместить.
Ещё три детали. Расписание задаётся в формате cron и всегда в UTC, часовые пояса не поддерживаются. Команде в Берлине придётся сдвинуть окно и помнить, что при переходе на летнее время оно уезжает на час. Чтобы днём останавливать только то, что тревожит поды, добавь в бюджет с расписанием reasons: ["Underutilized", "Drifted"]: пустые ноды тогда продолжат уходить в пределах постоянного бюджета с округлением вверх. И главное: бюджеты ограничивают только добровольные замены, то есть консолидацию, удаление пустых нод и дрейф. Истечение срока (expireAfter, по умолчанию 720h) и прерывания относятся к принудительным методам, и бюджеты NodePool их не сдерживают. PDB по-прежнему влияют на то, как освобождается нода, но отозванный спотовый инстанс они не спасут.
5m это стартовая точка, а не магическое значение. Понаблюдай за частотой замен нод полную неделю, потом решай, растянуть его или сократить.
Обновление, октябрь 2026: в Karpenter v1.14 (июль 2026) появилась третья политика,
consolidationPolicy: Balanced. Она по-прежнему убирает пустые и явно недогруженные ноды, но пропускает консолидацию, если экономия мала по сравнению с тем, сколько подов придётся потревожить. Если частые замены нод вызваны мелкими перестановками, попробуй её на одном NodePool, прежде чем увеличиватьconsolidateAfter.
Бюджеты ограничивают, сколько нод Karpenter трогает одновременно. PDB ограничивают, сколько подов одного приложения вытесняется за раз:
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: frontend-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: frontend
Этот PDB блокирует любое добровольное вытеснение, после которого останется меньше двух здоровых подов frontend. При четырёх репликах одновременно можно вытеснить две. При двух репликах нельзя ни одной, и это обратная сторона ловушки. Karpenter не станет добровольно убирать ноду, пока PDB блокирует хотя бы один её под. Консолидация пропускает такую ноду, дрейф тоже, если в NodePool не задан terminationGracePeriod. В событиях появится что-то вроде pdb default/frontend-pdb prevents pod evictions. Это второй урок Salesforce: слишком строгие или неверно настроенные PDB мешали заменять ноды, и команда добавила политики Open Policy Agent (OPA), которые проверяют PDB заранее. И ещё одно ограничение: от непроизвольных сбоев PDB не защищает. Отзыв спотового инстанса или отказ железа заберёт поды в любом случае.
Для настоящих одиночек запусти вторую реплику, если приложение это позволяет. Если нет, аннотация karpenter.sh/do-not-disrupt: "true" на поде блокирует консолидацию его ноды, а значение вроде "30m" защищает под только первые 30 минут после запуска. Но если у NodeClaim задан terminationGracePeriod, Karpenter всё равно может заменить ноду из-за дрейфа. Истечение срока, прерывания, автоматический ремонт нод и ручное удаление аннотация не блокирует. Если задан expireAfter, документация советует задать и terminationGracePeriod, чтобы защищённый под не держал ноду вечно. Своё решение в Salesforce описывают как функции гарантированного времени жизни пода и политики замены нод, которые учитывают особенности нагрузки; в стандартном Karpenter рычаг такого рода как раз эта аннотация.
Поэтапный переход
В Salesforce описали, как разбили переход на этапы, и эту часть полезно перенять целиком:
- Сначала инструменты. Собственный инструмент перехода запрещал размещать новые поды на старых нодах, а затем освобождал их, строго соблюдая PDB. Он умел работать и в обратную сторону, назад к масштабированию через группы Auto Scaling, и был встроен в CI/CD-конвейер инфраструктуры.
- Конфигурацию переводит код. Настройки групп Auto Scaling автоматически превращались в описания NodePool и EC2NodeClass, а пулов нод было больше 1180.
- Паузы между этапами. Переход растянули с середины 2025 до начала 2026 года. Начали с окружений с меньшим риском, между этапами наблюдали за кластерами, а самые критичные продакшен-окружения оставили напоследок.
- Притормозить, когда больно. Параллельный cordon нод привёл к проблемам со здоровьем кластера, и команда перешла на последовательный, с ручными контрольными точками, возможностью отката и усиленным мониторингом.
- Скучные блокеры. Старые имена длиннее 63 символов (это предел Kubernetes для меток) и настройки эфемерного хранилища, которые пришлось переносить из старой конфигурации томов один в один.
Для каждого кластера чек-лист этой статьи, собранный из ловушек выше, тогда выглядит так:
- Развести поды. Taint и обязательная affinity для системной группы нод, NodePool для всего остального (ловушка 2).
- Ограничить каждый NodePool.
limitsна сумму,instance-cpuна размер ноды, оба типа мощностей там, где нагрузка переносит Spot (ловушка 1). - Проверить PDB и бюджеты до первого освобождения нод. Найти PDB, которые не разрешают ни одного вытеснения, и нагрузки с одной репликой, добавить к бюджету на рабочие часы постоянный (ловушка 3).
- Наблюдать, потом переходить к следующему этапу. Метрики и обработка прерываний должны работать до того, как переезжает продакшен (следующий раздел).
Старые группы нод сжимай медленно. Руководство по миграции советует уменьшать их на несколько инстансов за раз и следить за нагрузками, у которых не хватает реплик или нет PDB.
Следи за правильными сигналами
Karpenter по умолчанию отдаёт метрики Prometheus на порту 8080. Вот те, что рассказывают историю миграции:
karpenter_nodes_created_totalиkarpenter_nodes_terminated_total: частота замен нод, с метками NodePool и зоны.karpenter_nodeclaims_disrupted_total: замены нод по причинеreason(например,underutilized,drifted,expired) и по NodePool.karpenter_pods_startup_duration_seconds: время от создания пода до запуска.karpenter_nodepools_allowed_disruptions: сколько нод бюджеты разрешают убрать прямо сейчас, по каждому NodePool.karpenter_interruption_received_messages_total: сообщения из очереди прерываний, по типам.
Для алерта на частые замены нужен increase() за окно, он даёт количество:
# Больше 20 удалённых нод в одном NodePool за час
sum by (nodepool) (increase(karpenter_nodes_terminated_total[1h])) > 20

# Что вызывает замены
sum by (nodepool, reason) (increase(karpenter_nodeclaims_disrupted_total[1h]))
Порог 20 условный. Свой подбери по данным за обычную неделю. Не меняй это на rate(), не посчитав: он возвращает значение в секунду, так что rate(karpenter_nodes_terminated_total[5m]) > 5 означает примерно 1500 удалений за пять минут. Если один Prometheus собирает несколько кластеров, добавь метку кластера в by (...).
Прерывания: один обработчик на ноду
Прерывания спотовых инстансов обрабатывает сам Karpenter. Он читает очередь SQS, в которую правила EventBridge складывают предупреждения о прерывании Spot, события планового обслуживания и события остановки или удаления инстансов. Шаблон CloudFormation из руководства по началу работы с Karpenter создаёт и очередь, и правила. Потом остаётся указать очередь в Helm-чарте через settings.interruptionQueue (флаг --interruption-queue). Без очереди Karpenter не обрабатывает события из SQS, но отдельно продолжает проверять состояние инстансов через API EC2. Получив предупреждение о прерывании Spot, Karpenter начинает запускать замену и параллельно освобождать старую ноду. Успеть до отзыва инстанса удаётся не всегда.
Не добавляй AWS Node Termination Handler для тех же нод. FAQ Karpenter не рекомендует запускать оба компонента, потому что они обрабатывают одни и те же события. Единственное задокументированное исключение: рекомендации о ребалансировке Spot, на которые Karpenter не реагирует. Если без них никак, NTH может работать рядом. Но документация предупреждает о лишних заменах нод, вплоть до цикла: NTH убирает ноду, а Karpenter снова запускает тот же тип инстанса.
Начни с малого, измеряй, потом масштабируй
Такой поэтапный переход подойдёт и одной команде. Начни с одного некритичного NodePool: внутренние инструменты, тестовые окружения, пакетные задачи. Измеряй его хотя бы полный недельный цикл, чтобы увидеть и пиковые дни, и тихие ночи. Смотри на время запуска подов, частоту замен нод по причинам, ответы на вытеснение (у karpenter_pods_eviction_requests_total есть метка с кодом ответа, а 429 значит, что вытеснение запретил PDB или API-сервер ограничил частоту запросов) и стоимость каждой нагрузки. Потом переходи к следующему этапу, заранее подготовив план отката.
Вернёмся к загадке из начала. Самые большие цифры в кейсе операционные: на 80% меньше ручной работы, минуты превратились в секунды, тысячи групп нод исчезли. Экономия настоящая и скромная. А все проблемы из списка о том, как убирать и менять ноды: PDB, cordon, одиночные поды. Планируй миграцию прежде всего вокруг этого. Экономия получится такой, какую позволят нагрузки, и измеришь её сам.
Исправление, октябрь 2026: в прошлой версии статьи говорилось, что в Salesforce сократили стоимость кластеров на 70% и создавали ноды быстрее 60 секунд. Ещё им приписывалось разделение между Cluster Autoscaler и Karpenter. В опубликованном кейсе ничего этого нет. Цифры в этой версии взяты только из статьи в блоге AWS Architecture, ссылка на неё стоит в начале.
Связанные материалы
- Доклад: Karpenter в продакшене: архитектура экономичных K8s кластеров, AWS Community Day Slovakia, Кошице, 2026-03-11.
- Доклад: Масштабирование Kubernetes с Karpenter, Code Europe, Краков, 2025-07-01.
- Кейс: How Salesforce migrated from Cluster Autoscaler to Karpenter across their fleet of 1,000 EKS clusters, блог AWS Architecture, 2026-01-12.
- Документация Karpenter: NodePools, Disruption, Metrics, Migrating from Cluster Autoscaler.
- AWS Summit Warsaw 2026, сессия DOP202 (2026-05-06): Integrated AI Agents & Code Assistants with MCP & AWS.
- LinkedIn: linkedin.com/in/vedmich.