Строим RCA-агента на Amazon Bedrock AgentCore
По материалам моего доклада на AWS Community Day Central Asia: как один вопрос «почему под перезапускается?» вырастает из одного вызова модели в ограниченный цикл расследования, что нужно, чтобы такого агента эксплуатировать, и какую роль играют Strands и AgentCore.
Виктор Ведмич · 13 мин чтения
Вечер финала турнира. Матчмейкинг начинает сыпать ошибками, срабатывает пейджер, и первый вопрос в инцидентном канале всё тот же: почему этот под перезапускается?
Что будет дальше, вы знаете, потому что сами это делали. Открываете алерт. Делаете kubectl describe по поду. Идёте в CloudWatch за логами, в Prometheus за графиком памяти, в вики за ранбуком, который кто-то написал в прошлом году. Один инцидент, несколько систем, а настоящая работа происходит у вас в голове: связать улики между собой.
Как раз сбор и сопоставление улик машина может взять на себя первой. Только не чат-ассистент, который объясняет вставленный в чат лог: это копилот, и он отвечает на вопросы. В 2 часа ночи мне нужен агент. Агент сам выбирает следующую проверку, сам обращается к системам и приносит отчёт с уликами. Копилот отвечает. Агент расследует.
Это текстовая версия моего доклада про агента для анализа первопричин инцидентов (root cause analysis, RCA), с которым я выступил на AWS Community Day Central Asia 2026 в Ташкенте. План тот же:
- Какие возможности нужны агенту?
- Что нужно, чтобы его эксплуатировать?
- Чем помогают Strands и AgentCore?
- Как собрать своего RCA-агента?
Вся дека доступна онлайн, а её слайды встроены прямо в текст, так что схемы можно пролистать по шагам. Запись демо ближе к концу.
Один вопрос, пять слоёв
Самый понятный способ объяснить агента, который я знаю: взять один вопрос и отвечать на него снова и снова, каждый раз добавляя одну возможность. На каждом шаге смотрим, что ответ может, а чего не может. (Ответы и значения ниже иллюстративные и синтетические, как и на слайдах.)
Только модель: правдоподобно и в общем
Спросите генеративную модель «почему под перезапускается?», и вы получите хороший ответ на другой вопрос. Частые причины: контейнеру не хватило памяти (OOMKilled), процесс падает на старте, не проходит liveness- или startup-probe, плохой конфиг или образ. Сделайте kubectl describe pod и посмотрите последнюю причину завершения.
Это полезный общий совет, но в 2 часа ночи он ничего не объясняет. Такой ответ подходит любому поду где угодно. Причина простая. Модель предсказывает следующий токен по тому, что лежит в промпте. Её знания заканчиваются на дате обучения, памяти между вызовами у неё нет, доступа к вашему кластеру тоже. Контекст: единственный канал в модель. Всё дальнейшее сводится к тому, чтобы передавать через этот канал данные получше.
Добавляем наши знания через RAG
Retrieval-augmented generation (RAG) добавляет в промпт наши собственные документы. Вопрос служит запросом к индексу ранбуков, и самые подходящие фрагменты вместе со ссылкой на источник попадают в контекст.
Ответ меняется: «В вашем ранбуке лимиты памяти match-api указаны как известный риск. Проверьте последнюю причину завершения и сравните потребление памяти с настроенным лимитом за период инцидента».
Теперь ответ опирается на наши знания. Но посмотрите, чего всё ещё нет: на сам под никто не взглянул. Поиск возвращает текст ранбука, а не текущие данные из кластера.
Добавляем живые инструменты через MCP
Здесь картина меняется. С инструментами модель может запросить наблюдение. Через Model Context Protocol (MCP) приложение предлагает модели список инструментов, например eks_describe_pod. Модель предлагает вызов, а выполняет его приложение.
Теперь в контексте результат инструмента (синтетический, как и все значения здесь): последнее завершение OOMKilled, exit code 137, лимит памяти 512Mi. И ответ наконец про этот под: «Предыдущий контейнер завершился по OOM (exit 137) при лимите 512Mi. Следующая проверка: working set памяти за последний час и история деплоев. Пока не установлено, почему выросло потребление памяти».
Одна деталь на этом слайде важнее всего остального в первой половине: модель предлагает вызов, а делает его приложение. Модель никогда не трогает ваш кластер. Ваше приложение проверяет политику, вызывает MCP-сервер и возвращает наблюдение. Права живут в коде и конфигурации, а не в добрых намерениях модели. (Если MCP вам в новинку, начните с MCP-серверов простыми словами.)
Цикл сам выбирает следующую проверку
Один вызов инструмента даёт модели одно наблюдение. Агентной систему делает цикл, который это наблюдение использует. Смотрим на собранные улики, выбираем следующую проверку в разрешённых рамках, вызываем ограниченный инструмент, смотрим на наблюдаемый результат и решаем: повторить, проверить что-то другое или остановиться.
Два свойства держат этот цикл под контролем. Он ограничен: лимиты на число вызовов инструментов, время и токены соблюдает приложение, а не модель, и когда лимит достигнут, агент останавливается и говорит, что установить не смог. И только наблюдаемый результат, в том числе ошибка, может запустить следующую проверку. Цикл движется вперёд на уликах, а не на том, что модель сама себя в чём-то убедила. Права доступа и недоверенный контент требуют отдельных механизмов, о них ниже.
Не всё должно быть агентом
Совет из доклада, который я дал бы любой команде: выбирайте подход под задачу. В workflow шаги заранее заданы в коде. Это предсказуемо, дёшево и легко тестируется. Агент позволяет модели выбирать следующий шаг, и за это вы платите задержкой, стоимостью и гораздо большим числом способов сломаться.
В дизайне RCA агентным сделано только само расследование. Приём алертов идёт фиксированным workflow с заданной схемой вебхука. Инструменты работают только на чтение. Решение об исправлении принимает человек. Оставьте агента там, где последовательность проверок нельзя задать заранее, а всё вокруг держите детерминированным.
Skills и subagents, когда они нужны
Картину дополняют ещё две возможности.
Skill задаёт переиспользуемую процедуру для повторяющейся работы. «Расследование рестарта» описывает, когда её применять (перезапуск контейнера, а не любой вопрос про Kubernetes), и как действовать: посмотреть предыдущее состояние завершения, сопоставить метрики со временем рестарта, сравнить правдоподобные причины, привести улики и перечислить недостающие проверки. Skill подгружается в промпт, когда задача подходит под условия его применения. Skills дают инструкции. Инструменты дают возможности.
Subagent получает ограниченную задачу в свежем контексте. Контекст основного расследователя заполняется быстро: вопрос, состояние пода, фрагменты ранбуков, десять экранов логов и метрик. Если отдать «посмотри на память вокруг рестарта» специалисту по телеметрии, весь этот шум останется у него. Специалист возвращает сжатые выводы, а не свою переписку. Цена: задержка, ещё одна передача и в разы больше токенов, чем у одного агента. Делегировать стоит ради бюджета контекста, а не ради оргструктуры.
Это карта возможностей, а не обязательный стек. Добавляйте возможность, когда она нужна задаче. Прототип, который я показывал, использует модель, RAG и MCP-инструменты в цикле. Skills и subagents можно добавить по мере роста, начинать с них не нужно.
Эксплуатация: самое сложное
Всё, что было до сих пор, помещается на доске. А потом вы пытаетесь запустить это для настоящего on-call и выясняете, что цикл составляет лишь часть приложения. Рабочему агенту нужно окружение: где он работает, кто какой инструмент может вызывать, что нужно блокировать, что переживает отдельный запуск, какая версия промпта сейчас в работе и что произошло и почему.
Четыре пункта стоит разобрать подробнее.
Три решения о доступе, а не одно
Логин отвечает только на первый вопрос: кто может вызвать агента? Второй: что агенту можно делать своими инструментами. Посмотреть один workload можно. Изменить алерт нельзя. Третий вопрос все пропускают: контент. Логи нельзя считать доверенным вводом. Любой, кто может записать строку в лог, может записать текст, который окажется в контексте вашей модели. Относитесь к контенту как к уликам, а не как к указаниям.
У этого RCA-агента есть все три ингредиента, которые делают агента рискованным: приватные данные (кластер), недоверенный контент (логи) и канал наружу (отчёт). Поэтому каждая граница должна быть явной, в конфигурации, которую можно протестировать. Фраза «будь осторожен» в промпте не заменяет ни одно из этих решений.
У памяти три срока жизни
«Память» означает три разные вещи. Разговор живёт до конца расследования. Запись о расследовании (что запускалось, статус, где лежит отчёт) должна пережить сессию, потому что завтра её кто-то будет искать. А проверенное знание об инциденте, после того как человек подтвердил итог, может стать зацепкой для следующего инцидента. Зацепкой, которую надо проверить, а не причиной, которой надо верить. Канонические логи и ранбуки остаются в своих хранилищах, чтобы переиспользованный контекст всегда можно было сверить с источником.
Правка промпта считается релизом
Поменяли одну инструкцию, значит поменяли систему. Пример со слайда: новая инструкция заставляет агента рекомендовать больше памяти до того, как он прочитал состояние контейнера. Каждый ответ по-прежнему валиден. А расследование стало хуже.
Поэтому к промптам относимся как к коду. Версионируем промпт, инструменты и модель вместе. Проверяем изменения на прошлых инцидентах. Выкатываем с возможностью отката. В каждом отчёте указана версия системы, которая его сформировала, поэтому, когда два отчёта расходятся, вы знаете, что поменялось. Платформа может помочь оценить поведение. Решение о релизе остаётся за вами.
Три вида записей отвечают на три вопроса
Когда что-то пойдёт не так, вы зададите три разных вопроса, и на каждый нужна своя запись. Кто вызвал какой API и когда? Это аудит. Какие шаги выполнились, упали или заняли время, и был ли вообще диагностический шаг? Это трейсинг выполнения. Что модель на самом деле получила и вернула? Это сохранённые запросы и ответы модели. Ни одна запись не отвечает на все вопросы, а для каждой заранее нужно решить, кому дать доступ, какие чувствительные данные маскировать и сколько хранить.
Где тут Strands и AgentCore
Теперь сопоставим эти требования с AWS. Работу делают две части: Strands Agents, open-source SDK от AWS (Python и TypeScript), который крутит цикл агента в коде вашего приложения, и Amazon Bedrock AgentCore, набор сервисов для эксплуатации агентов в проде.
Strands приятно скучный. Агент в нём состоит из модели, списка инструментов и системного промпта:
return Agent(
    model=self._model,
    tools=tools,
    system_prompt=system_prompt,
)
Окружение для эксплуатации даёт AgentCore:
- Runtime хостит агента: среда выполнения и жизненный цикл сессии. Ваш entrypoint принимает запрос, крутит цикл Strands и возвращает отчёт.
- Gateway отдаёт агенту tool servers как MCP-инструменты: одно место для обнаружения и вызова инструментов.
- Identity отвечает на вопрос «чьими полномочиями?»: кто вызывающий на входе и какие учётные данные уходят к инструментам на выходе.
- Policy проверяет вызовы инструментов на пути через Gateway. Политики пишутся на Cedar и работают по принципу default-deny, так что «смотреть можно, менять нельзя» становится конфигурацией, которую можно протестировать, включая вызовы, которые должны быть запрещены.
- Memory может хранить проверенное знание об инцидентах для опционального поиска.
- Observability и Evaluations дают трейсы по каждому расследованию и способ оценить поведение до релиза.
Сноска на этом слайде для меня важнее всего. За вами остаются: версии промптов, долговечная запись о задаче, кейсы для оценки и решение о релизе. Платформа даёт инструменты контроля. Решения она за вас не принимает.
Три заметки из практики.
Сессия не заменяет запись о задаче. Runtime управляет сессиями, но запись о расследовании (статус и отчёт, которые можно найти после конца сессии) должна лежать в хранилище, которым владеет ваше приложение. Повторы и дубли алертов тоже ваши решения. Сессия их за вас не примет.
Memory хранит зацепки, а не истину. Сейчас прототип ищет по ранбукам. Поиск по прошлым инцидентам пока только запланирован. В этой схеме проверенный итог инцидента будет попадать в долговременную память через IngestData, API прямой загрузки, который появился у AgentCore Memory в сентябре 2026. Настроенные стратегии извлечения будут обрабатывать его асинхронно, а следующее расследование сможет искать получившиеся записи в пределах своей области. Если загрузка упала, сначала разберитесь с причиной, а потом запускайте повторно.
Observability: три переключателя, и включать их придётся вам. Три вида записей соответствуют трём возможностям AWS. AWS CloudTrail пишет аудит вызовов API, но по умолчанию не всё. Вызовы моделей Bedrock вроде InvokeModel и Converse приходят как management events. А вызовы AgentCore Runtime, Gateway и Memory, как и поиск по Knowledge Base, относятся к data events, и их нужно включать явно.
Второй переключатель в вашем коде: инструментируйте приложение, чтобы оно отправляло трейсы OpenTelemetry, и AgentCore Observability сохранит трейсы, спаны и метрики в Amazon CloudWatch.
Третий: логирование вызовов моделей Amazon Bedrock, которое сохраняет запросы и ответы модели в CloudWatch Logs, Amazon S3 или в оба места. По умолчанию оно выключено. Три записи, три переключателя. И диагноз всё равно нужно сверять с реальным наблюдением.
Собираем RCA-агента
Время для рабочего примера. Первая задача намеренно маленькая: тот самый под в 2 часа ночи.
- Собрать: состояние пода, логи, метрики и подходящий ранбук.
- Объяснить: диагноз, привязанный к этим наблюдениям, и чего не хватает.
- Передать: инженер проверяет и выбирает исправление.
Гипотеза в том, чтобы сократить повторяющийся сбор улик, а не заменить инженера.
В основе один агент-расследователь за gateway с четырьмя MCP tool servers:
| Сервер | На какой вопрос помогает ответить |
|---|---|
| EKS | Что случилось с подом? |
| CloudWatch | Что показывают логи, алармы и метрики? |
| Prometheus | Как менялся нужный ряд метрик? |
| Knowledge Base | Какой ранбук подходит? |
Вокруг него обычное приложение. Алерт из CloudWatch, Alertmanager или ручной запуск попадает в бэкенд, который его нормализует, сохраняет расследование и вызывает Runtime. Расследователь опрашивает инструменты и генерирует отчёт. Приложение сохраняет результат, а UI периодически его запрашивает.
Проект не публичный, но вот два фрагмента, которые я показывал со сцены. Расследователь собирается по стандартному паттерну Strands, а инструменты приходят из gateway:
with gateway_client as mcp:
    agent = Agent(
        model=bedrock_model,
        tools=mcp.list_tools_sync(),
        system_prompt=instructions,
    )
    result = agent(alert_text)
Инструкции намеренно короткие: расследовать указанный workload, собрать текущие наблюдения, объяснить причину и следующий шаг, назвать, каких улик не хватает.
А инструмент представляет собой обычную функцию с понятным контрактом. Эта отдаёт состояние пода и работает только на чтение:
@mcp.tool()
@log_tool_execution
def eks_describe_pod(
    pod_name: str, namespace: str = "rca-demo"
) -> dict[str, Any]:
    cmd = ["kubectl", "get", "pod", pod_name,
           "-n", namespace, "-o", "json"]
    result = subprocess.run(
        cmd, capture_output=True, text=True, timeout=30
    )
    ...
Она возвращает ресурсы и текущее и предыдущее состояние контейнера. За ранбуки отвечает один инструмент поиска, bedrock_kb_retrieve(query, top_k=3), тонкая обёртка над API Retrieve в Amazon Bedrock Knowledge Bases, который возвращает каждый фрагмент вместе с источником и оценкой релевантности. Запрос по типу сбоя, фрагменты подходящего ранбука, и дальше сверка этих рекомендаций с текущими уликами.
Что должен показывать полезный отчёт
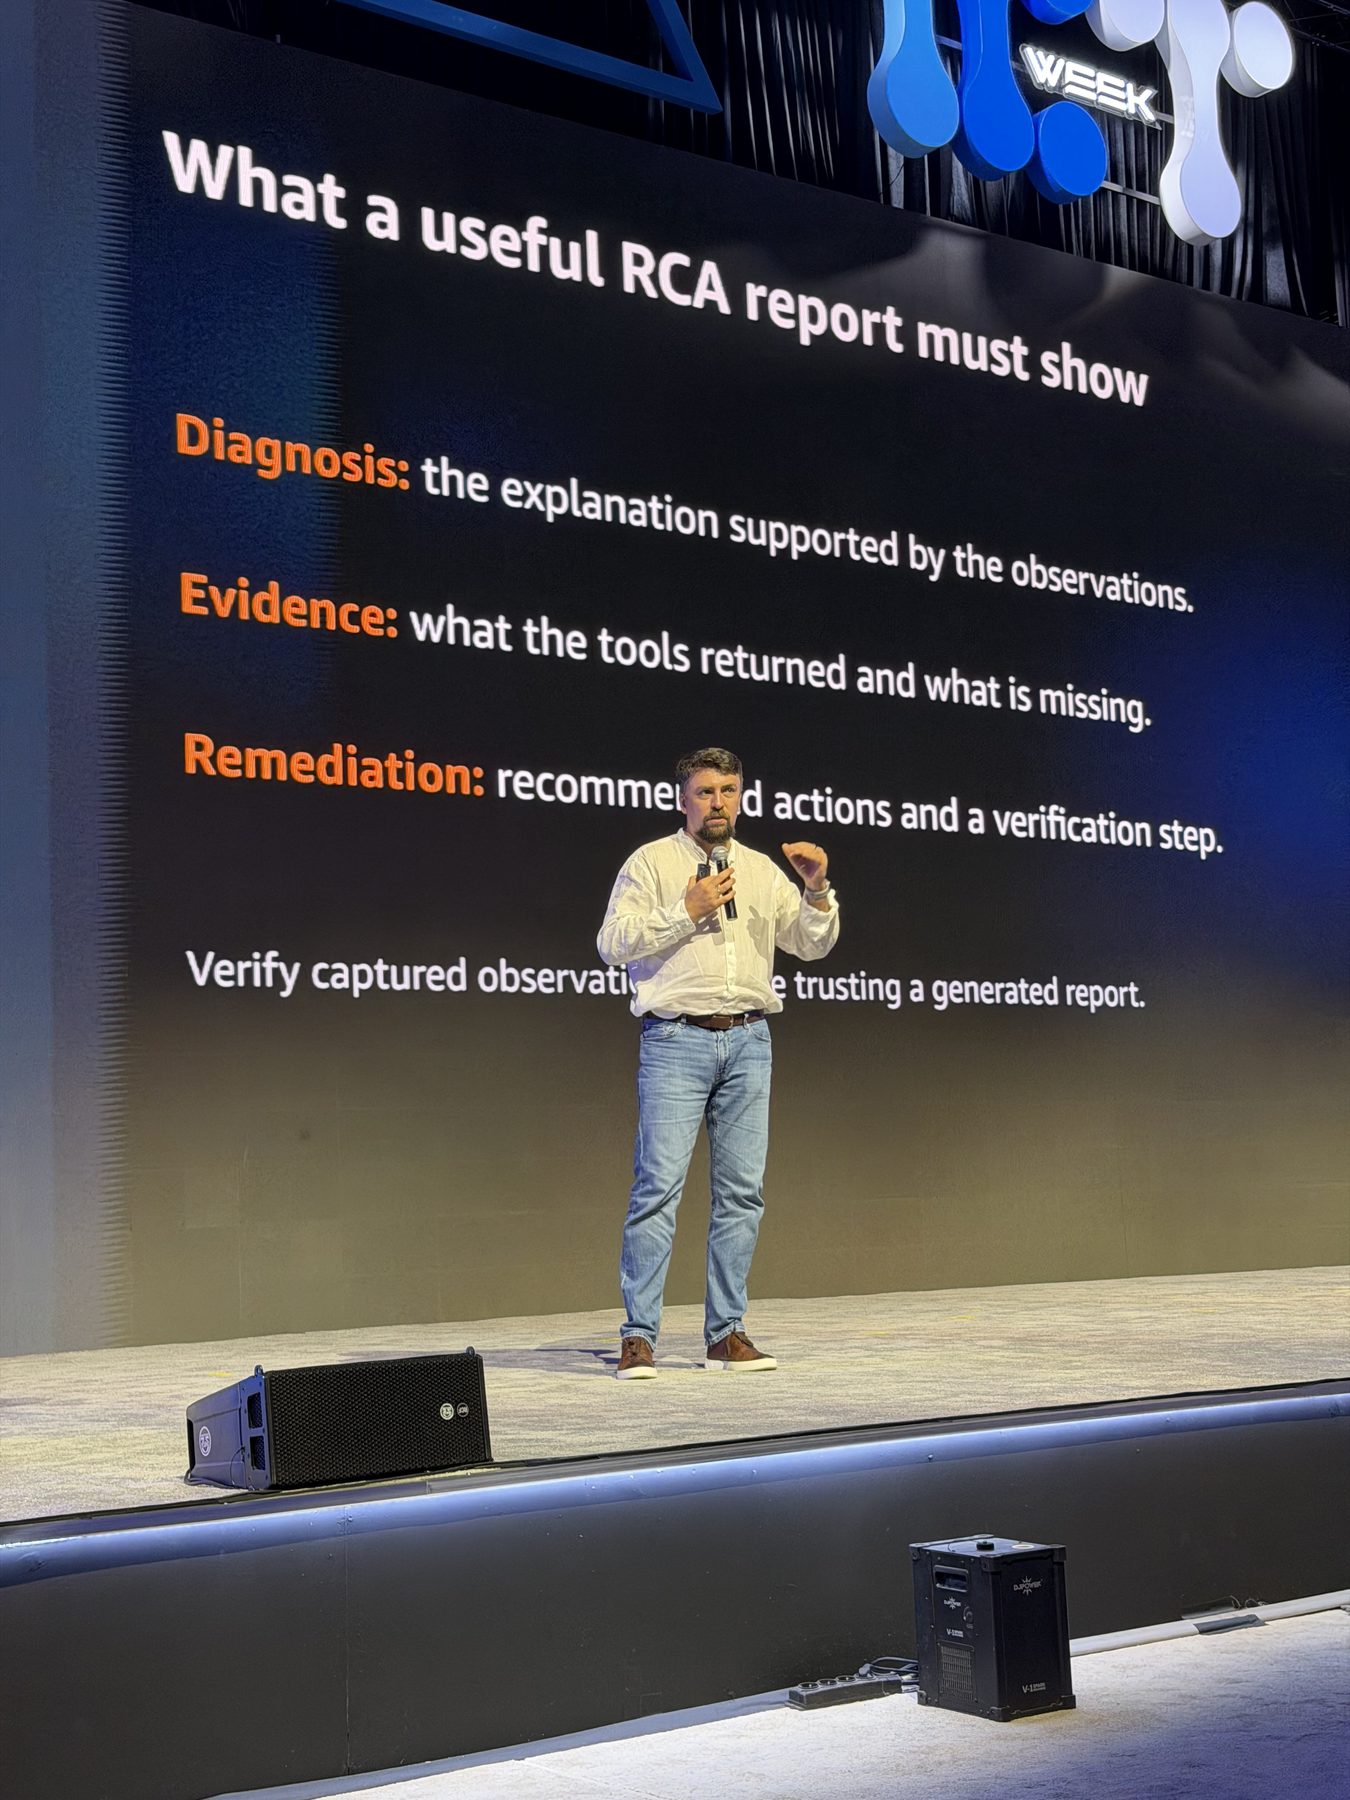
У полезного RCA-отчёта три части:
- Диагноз: объяснение, которое подтверждается наблюдениями.
- Улики: что вернули инструменты и чего не хватает.
- Исправление: рекомендуемые действия и шаг проверки.
И одно правило: прежде чем доверять сгенерированному отчёту, сверьте приведённые в нём наблюдения с результатами инструментов. Ценность отчёта в уликах, текст вокруг них лишь упаковка.
Демо
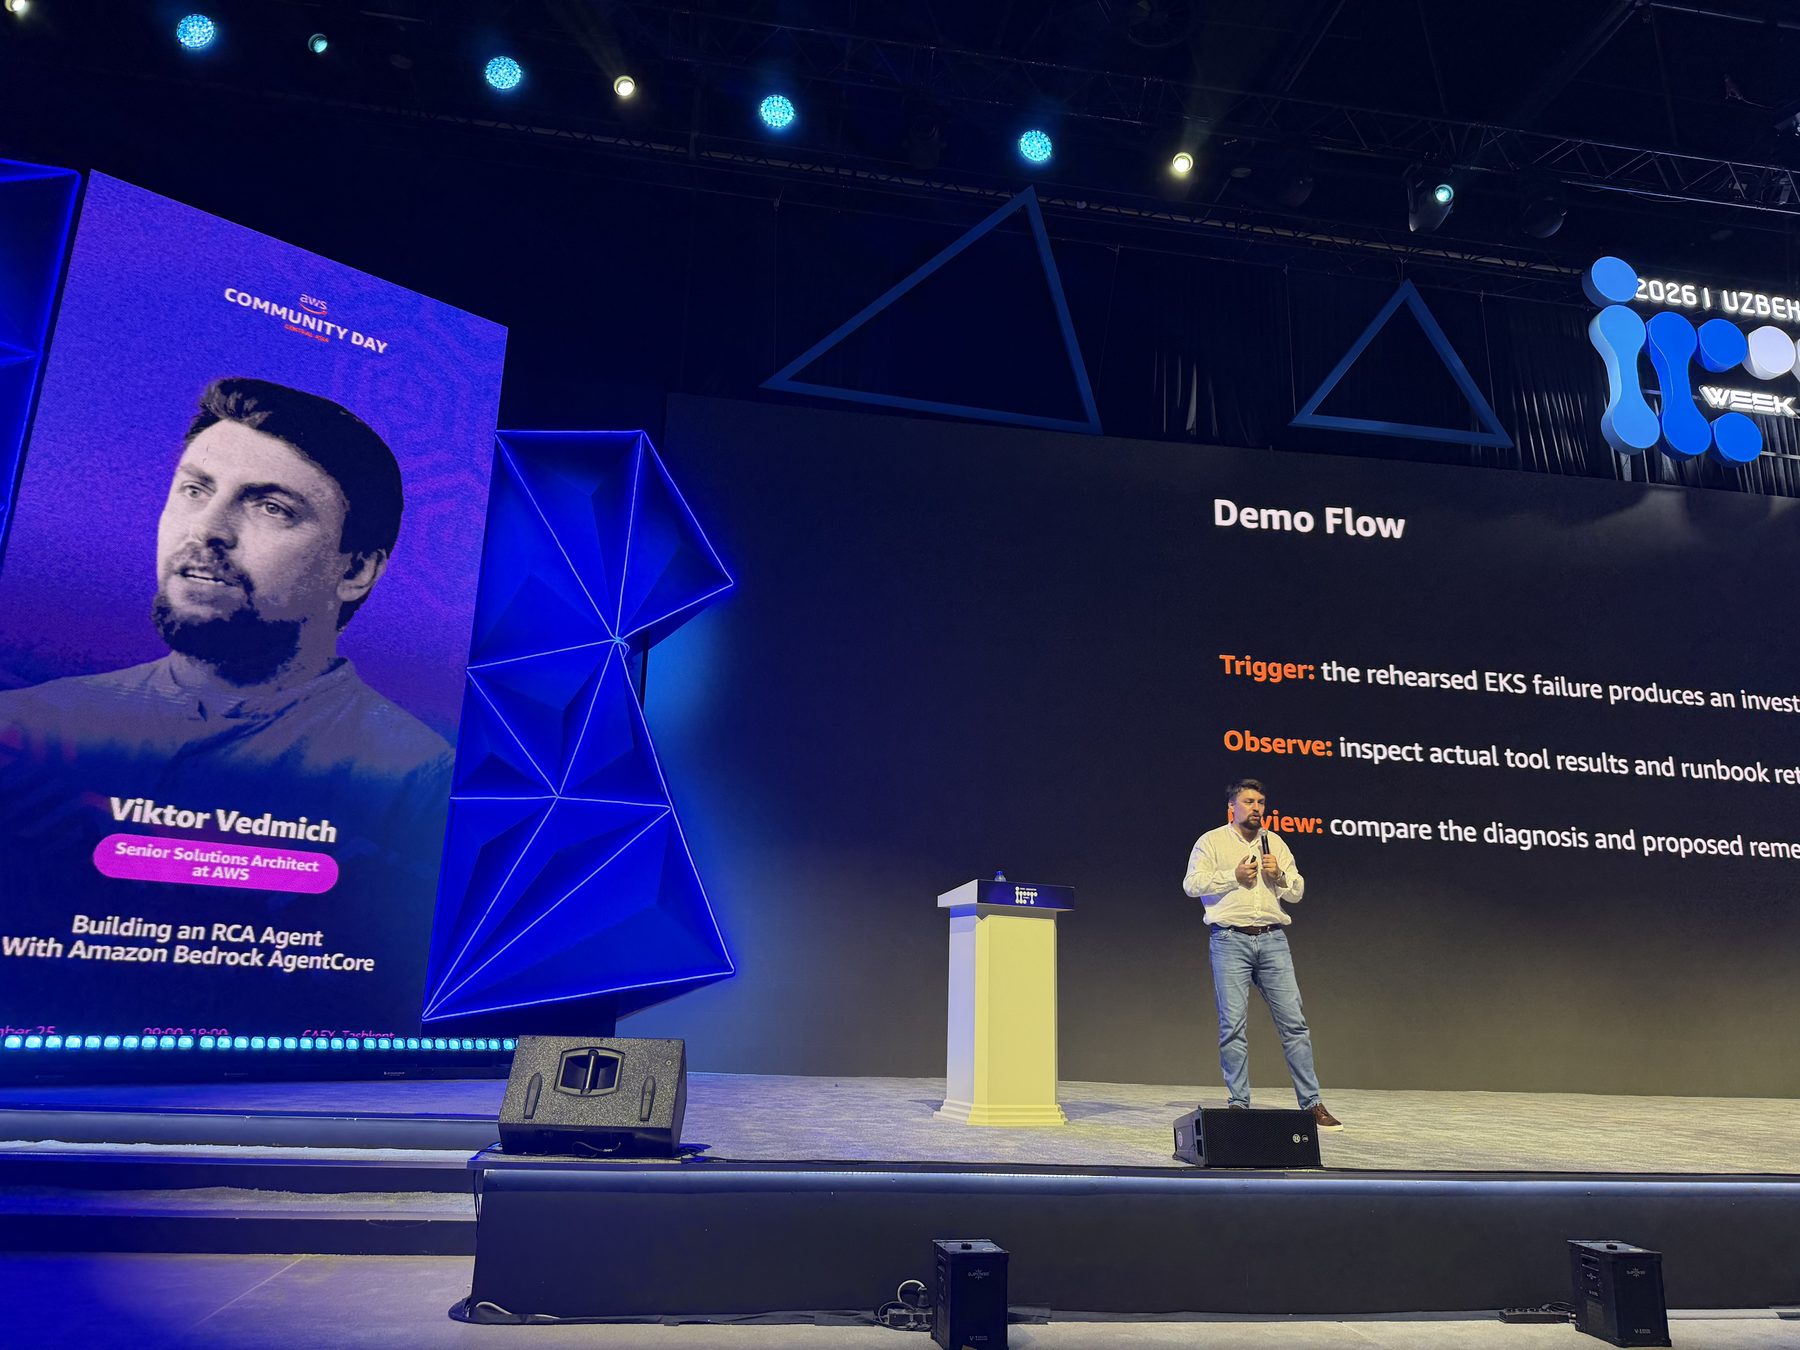
В демо было три шага. Заранее подготовленный сбой в EKS запускает расследование. Смотрим на реальные результаты инструментов и на найденный ранбук. Потом сверяем диагноз и предложенное исправление с уликами. Вот запись, которую я показывал в зале (2:49):
Строить или взять готовое?
Строить самому не обязательно. AWS DevOps Agent даёт управляемое расследование инцидентов и планы устранения. Действия, которые меняют ресурсы (directed actions), по умолчанию выключены, и каждое требует одобрения оператора в момент выполнения. AgentCore Harness даёт настроенного агента с управляемым циклом, которого потом можно экспортировать в код Strands. Свой цикл на Strands позволяет задать собственные контракты инструментов, ранбуки, формат отчёта и границы того, что агенту разрешено делать.
Моё правило из доклада: стройте сами, когда у вас особая телеметрия, свои ранбуки или особые ограничения на действия агента. В остальных случаях начинайте с управляемого варианта.
Что я вынес
Три вывода, которые я принёс бы своей команде:
- Стройте вокруг задачи. Полезный первый агент маленький. В докладе: один расследователь, четыре tool servers, один повторяющийся вопрос.
- Делайте улики проверяемыми. Отчёт показывает свои улики: причину завершения и лимит, процитированный фрагмент ранбука и то, что проверить не удалось.
- Эксплуатируйте как софт. Версионируйте, наблюдайте, оценивайте: версия в каждом отчёте, трейсы по каждому расследованию, прогон прошлых инцидентов перед релизом.
И одна привычка для дежурства: сформулируйте свою гипотезу до того, как читать выводы агента. Агент экономит время на сборе улик. Ваше суждение он заменять не должен.
День в Ташкенте
AWS Community Day Central Asia 2026 прошёл в пятницу, 25 сентября, в CAEx в Ташкенте, в последний день ICT Week Uzbekistan. Его провела AWS User Group Tashkent при поддержке юзер-групп Казахстана и Кыргызстана, а открылся он кейноутом Jeff Barr «Adapting to Change». Мой доклад был в 10:15. Спасибо Шахзоду Ходжаеву, Тарасу Терещенко и всей команде организаторов за отличный день.
Доклад я закончил вопросом, и задам его вам: что первым делом расследовал бы ваш агент?
Ссылки
- Слайды: Building an RCA Agent with Amazon Bedrock AgentCore, вся дека (52 слайда, записанное демо на слайде 44). Слайды на английском.
- Запись: трансляция всего дня на канале AWS User Group Uzbekistan. Мой доклад начинается примерно с 1:15:00.
- Страница доклада: Building an RCA Agent на AWS Community Day Central Asia.
- Для контекста: MCP-серверы простыми словами.
Источники
Утверждения про AWS, Strands и MCP сверены с этими официальными источниками 2026-10-03.
- What is Amazon Bedrock AgentCore? и как устроен AgentCore Runtime
- AgentCore Gateway и AgentCore Policy
- Прямая загрузка в AgentCore Memory (IngestData)
- AgentCore Observability и AgentCore Evaluations GA
- AgentCore Harness
- AWS DevOps Agent: directed actions
- CloudTrail для Amazon Bedrock и логирование вызовов моделей Bedrock
- Knowledge Bases Retrieve API
- Strands Agents: MCP tools
- Спецификация MCP: tools